מבוא לבינה מלאכותית RB40-03 : רשתות נוירונים חלק 1
חלק 1 : לימוד שפת פייתון לולאה , טענה של נתונים PANDA NUMPY
נלמד לקרוא נתונים מקובץ חיצוני, לעבד אותם, לבצע חישובים סטטיסטיים ולהציג את התוצאות בצורה גרפית באמצעות Python בסביבת Google Colab.
נושאי הלימוד
- Google Colab – עבודה בסביבת Python והעלאת קבצים מהמחשב.
- CSV – מבנה קובץ נתונים המכיל שורות ועמודות.
- Pandas – קריאת קובץ CSV, שימוש ב־DataFrame ובחירת עמודות נתונים.
- NumPy – המרת נתונים למערכים מספריים מסוג
float64. - לולאת FOR – מעבר על איברי מערך וביצוע חישובים.
- תנאי IF – השוואת ערכים ומציאת מינימום ומקסימום.
- סטטיסטיקה בסיסית – חישוב ממוצע, שונות וסטיית תקן.
- Matplotlib – יצירת גרף X מול Y, כותרות, צירים ורשת.
- ניתוח תוצאות – הבנת משמעות הנתונים והגרף.
תרגיל מעשי
קובץ אקסל CSV לתרגיל : polynomial_polar_25_points
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 |
# Import libraries import pandas as pd # Read and process CSV files import numpy as np # Work with numerical arrays import matplotlib.pyplot as plt # Draw graphs from google.colab import files # Upload files from the PC from io import BytesIO # Read uploaded file bytes # -------------------------------------------------- # Step 1: Upload CSV file from the PC # -------------------------------------------------- uploaded = files.upload() # Open the file selection window filename = next(iter(uploaded)) # Get the uploaded filename # -------------------------------------------------- # Step 2: Read CSV using Pandas # -------------------------------------------------- df = pd.read_csv(BytesIO(uploaded[filename])) # Load CSV into DataFrame df.columns = df.columns.str.strip().str.lower() # Normalize column names print("CSV Data:") print(df.head()) # Display the first 5 rows # -------------------------------------------------- # Step 3: Convert X and Y to NumPy float arrays # -------------------------------------------------- X = df["x"].to_numpy(dtype=np.float64) # X values as float64 Y = df["y"].to_numpy(dtype=np.float64) # Y values as float64 print("X:", X) # Display X array print("Y:", Y) # Display Y array # -------------------------------------------------- # Step 4: Calculate statistics using FOR loops # -------------------------------------------------- N = len(X) # Number of elements if N == 0: # Check that X is not empty raise ValueError("X array is empty") total = 0.0 # Sum of X values minimum = X[0] # Initial minimum value maximum = X[0] # Initial maximum value for value in X: # Visit every X value total += value # Add value to total if value < minimum: # Check for a smaller value minimum = value # Update minimum if value > maximum: # Check for a larger value maximum = value # Update maximum mean = total / N # Calculate mean # Calculate standard deviation sum_squared = 0.0 # Sum of squared differences for value in X: # Visit every X value difference = value - mean # Difference from the mean sum_squared += difference**2 # Add squared difference variance = sum_squared / N # Population variance std = np.sqrt(variance) # Standard deviation # -------------------------------------------------- # Step 5: Display results # -------------------------------------------------- print("\nStatistical Results for X:") print("Number of values:", N) print("Mean:", mean) print("Standard Deviation:", std) print("Minimum:", minimum) print("Maximum:", maximum) # -------------------------------------------------- # Step 6: Plot X versus Y # -------------------------------------------------- plt.figure(figsize=(9, 5)) # Figure size in inches plt.plot( X, Y, # X and Y arrays marker="o", # Circle markers linestyle="-", # Solid connecting line color="blue", # Line color label="CSV Data" # Legend text ) plt.title("CSV Data - X vs Y") # Graph title plt.xlabel("X") # Horizontal axis plt.ylabel("Y") # Vertical axis plt.grid(True) # Show grid plt.legend() # Show legend plt.show() # Display graph |
תרגיל מעשי נוסף לימוד שפת פייתון יצירת נתונים סינטטיים
נלמד:
- NumPy – יצירת מערך מספרים מסוג Float בתחום נתון.
- פונקציה פולינומית – חישוב ערכי X ו־Y באמצעות משוואה מתמטית ממעלה שמינית.
- יצירת נתונים – יצירת 100 נקודות במרווחים שווים.
- רעש אקראי (Gaussian Noise) – יצירת רעש בהתפלגות נורמלית והבנת משמעות הממוצע וסטיית התקן.
- הוספת רעש לנתונים – הדמיית שגיאות מדידה באמצעות הוספת רעש לערכי Y.
- Matplotlib – הצגת הפונקציה המקורית והנתונים הרועשים על אותו גרף.
- לולאת FOR – מעבר על איברי מערך והדפסת נתונים.
- עיצוב פלט – הצגת מספרים עם מספר מוגדר של ספרות לאחר הנקודה העשרונית.
- ניתוח גרפים – השוואה בין פונקציה מתמטית מדויקת לבין נתונים המכילים רעש.
מטרת התרגיל: להבין כיצד ליצור ולעבד נתונים מתמטיים באמצעות Python, לדמות רעש במדידות ולהציג את התוצאות בצורה גרפית.
התרגיל מהווה בסיס להכנת נתונים לאימון רשתות נוירונים מסוג ANN.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 |
import numpy as np # ספרייה לחישובים מתמטיים ומערכים import matplotlib.pyplot as plt # ספרייה להצגת גרפים # ---------------------------------------------------- # שלב 1: יצירת מערך X # ---------------------------------------------------- N = 100 # מספר הנקודות שניצור X = np.linspace(-2, 2, N) # יצירת 100 מספרים בין מינוס 2 לפלוס 2 # ---------------------------------------------------- # שלב 2: חישוב הפונקציה הפולינומית # ---------------------------------------------------- Y = (0.5 * X**8 # איבר בחזקה שמינית - 4 * X**6 # איבר בחזקה שישית + 10 * X**4 # איבר בחזקה רביעית + 0.25 * X**3 # איבר בחזקה שלישית - 8 * X**2 # איבר בחזקה שנייה - 0.6 * X # איבר ליניארי + 2) # קבוע חופשי # ---------------------------------------------------- # שלב 3: יצירת רעש אקראי מסוג Gaussian # ---------------------------------------------------- rng = np.random.default_rng(42) # יצירת מחולל מספרים אקראיים עם זרע קבוע noise = rng.normal( loc=0, # ממוצע הרעש הוא אפס scale=0.2, # סטיית התקן של הרעש היא 0.2 size=N # יצירת 100 ערכי רעש אקראיים ) # ---------------------------------------------------- # שלב 4: הוספת הרעש לפונקציה # ---------------------------------------------------- Y_noisy = Y + noise # הוספת ערך רעש לכל נקודה במערך Y # ---------------------------------------------------- # שלב 5: הצגת הפונקציה המקורית והרועשת בגרף # ---------------------------------------------------- plt.figure(figsize=(10, 5)) # הגדרת גודל הגרף באינצ'ים plt.plot( X, Y, # ערכי X וערכי Y המקוריים color="blue", # צבע הקו כחול linewidth=2, # עובי הקו label="Original Function" # שם הפונקציה במקרא ) plt.scatter( X, Y_noisy, # הצגת ערכי X וערכי Y עם רעש color="orange", # צבע הנקודות כתום s=25, # גודל הנקודות label="Function with Noise" # שם הנתונים במקרא ) plt.title("Polynomial Function with Gaussian Noise") # כותרת הגרף plt.xlabel("X") # כותרת ציר אופקי plt.ylabel("Y") # כותרת ציר אנכי plt.grid(True) # הוספת רשת לגרף plt.legend() # הצגת מקרא הגרף plt.show() # הצגת הגרף על המסך # ---------------------------------------------------- # שלב 6: הדפסת 10 הנקודות הראשונות # ---------------------------------------------------- print("X Original Y Noisy Y") # כותרות העמודות for i in range(10): # מעבר על 10 הנקודות הראשונות print( f"{X[i]:.3f} " # הדפסת X עם 3 ספרות אחרי הנקודה f"{Y[i]:.3f} " # הדפסת Y המקורי f"{Y_noisy[i]:.3f}" # הדפסת Y לאחר הוספת הרעש ) |
חלק 2
חלק א :מבוא לרשתות נוירונים (ANN)
1. מהי רשת נוירונים?
רשת נוירונים מלאכותית (Artificial Neural Network – ANN) היא מודל מתמטי בתחום הבינה המלאכותית, המסוגל ללמוד קשרים ודפוסים מתוך נתונים.
בניגוד לתוכנה רגילה, שבה המתכנת מגדיר את כל כללי הפעולה, רשת נוירונים לומדת את הקשרים באמצעות דוגמאות.
דוגמה: במקום לכתוב נוסחה המתארת קשר מורכב בין X ל־Y, נספק לרשת מאות דוגמאות של X ו־Y. הרשת תנסה ללמוד את הקשר ולחזות ערכי Y חדשים.
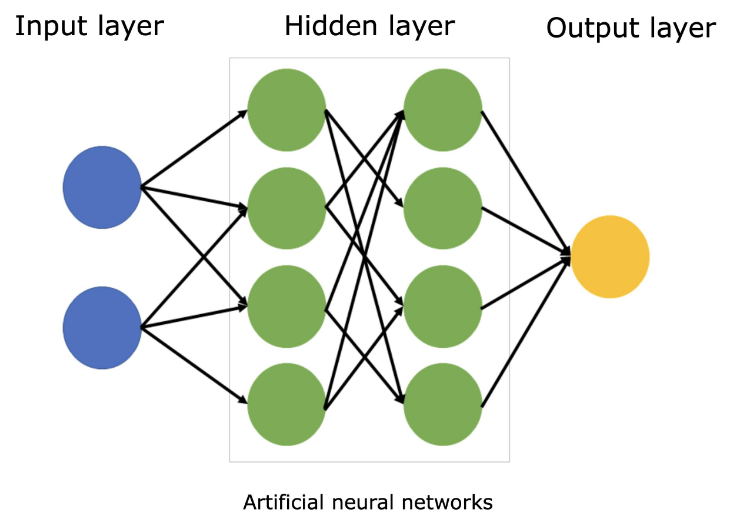
רשת נוירונים בסיסית מכילה שלושה סוגי שכבות:
| שכבה | תפקיד |
|---|---|
| Input Layer | קבלת הנתונים |
| Hidden Layers | עיבוד הנתונים ולמידת קשרים |
| Output Layer | הפקת התוצאה או החיזוי |
כיצד רשת נוירונים לומדת באמצעות MSE, משקלים ונגזרות?
|
1 2 |
x = np.array([0, 1, 2, 3, 4], dtype=float) y = np.array([1, 3, 5, 7, 9], dtype=float) |
הסבר מהו MSE
ישור להרצה ולקוד : https://colab.research.google.com/drive/1DOd4WaXNnc_1Hf3qkwUJhBvl7k79Wogj?usp=sharing
y=2x+1 אבל הבינה מלאכותית לומד את את החוקיות הקשרים ולא את הנוסחה – לאחר הלמודה TRAIN האימון היא תוכל לנבא
הניבוי יהיה שתקבל X כקלט ותנבא מה יהיה ה Y
ואם ניראה דוגמא מתמקדת יותר
https://colab.research.google.com/drive/1GPIltR9QLWONZCDBlWj7V3Shqm6KhGLD?usp=sharing
Artificial Neural Networks – Weights, Bias, MSE, Gradient Descent and Backpropagation
1. מהי למידה ברשת נוירונים?
רשת נוירונים מלאכותית (ANN) היא מודל מתמטי הלומד קשר בין נתוני קלט (X) לבין תוצאות רצויות (Y).
הרשת לומדת באמצעות שינוי שני סוגי פרמטרים:
-
Weights (משקלים): קובעים את השפעת כל קלט על הנוירונים.
-
Biases (הטיות): ערכים נלמדים שמתווספים לחישוב של כל נוירון.
במהלך האימון הרשת משנה את הפרמטרים כדי להקטין פונקציית שגיאה (Loss Function).
בקוד שלנו בחרנו בפונקציה MSE – Mean Squared Error.
מהו MSE וכיצד רשת נוירונים לומדת מהטעויות שלה?
1. מהו MSE?
כאשר אנחנו מאמנים רשת נוירונים, אנחנו נותנים לה דוגמאות ומבקשים ממנה ללמוד את הקשר ביניהן.
לדוגמה, אנחנו נותנים לרשת מספר X ומבקשים ממנה לחזות את התוצאה Y.
בהתחלה הרשת אינה יודעת מה התוצאה הנכונה ולכן היא עשויה לטעות.
כדי לדעת עד כמה הרשת טועה, אנחנו משתמשים במדד שנקרא:
MSE – Mean Squared Error
בעברית: ממוצע השגיאות הריבועיות.
MSE הוא מספר שמאפשר לנו למדוד את השגיאות של הרשת.
ככל שהמספר קטן יותר, כך התחזיות קרובות יותר לתוצאות האמיתיות, בממוצע לפי מדד זה.
המטרה של הרשת בזמן האימון היא להקטין את ה־MSE.
2. דוגמה פשוטה
נניח שיש לנו חמישה נתונים.
| X – קלט | Y – תוצאה אמיתית |
|---|---|
| 0 | 1 |
| 1 | 3 |
| 2 | 5 |
| 3 | 7 |
| 4 | 9 |
אנחנו נותנים לרשת הנוירונים את הנתונים האלה כדי שתלמד את הקשר בין X לבין Y.
במקרה שלנו, הקשר האמיתי הוא:
Y = 2 × X + 1
אבל הרשת אינה מקבלת את הנוסחה. היא מקבלת רק את הדוגמאות.
לאחר מספר שלבי אימון, נניח שהרשת מחזירה את התחזיות הבאות:
| X | Y אמיתי | Ŷ חזוי |
|---|---|---|
| 0 | 1 | 1.5 |
| 1 | 3 | 2.5 |
| 2 | 5 | 4.0 |
| 3 | 7 | 6.5 |
| 4 | 9 | 8.5 |
מה פירוש Ŷ?
הסימון Ŷ נקרא Y Hat.
- Y הוא הערך האמיתי.
- Ŷ הוא הערך שרשת הנוירונים חזתה.
אפשר לראות שהתחזיות של הרשת קרובות לתוצאות האמיתיות, אבל עדיין קיימות שגיאות.
הערכים החזויים כאן נבחרו לצורך הדוגמה ולא נלקחו מהרצה אמיתית של הרשת.
3. כיצד מחשבים את השגיאה? Error
השלב הראשון הוא לחשב את ההפרש בין התוצאה האמיתית לתחזית של הרשת.
הנוסחה:
Error = Y − Ŷ
לדוגמה:
התוצאה האמיתית היא:
Y = 1
אבל הרשת חזתה:
Ŷ = 1.5
לכן:
Error = 1 − 1.5 = −0.5
התוצאה שלילית משום שהרשת חזתה מספר גבוה יותר מהתוצאה האמיתית.
דוגמה נוספת:
Y = 5
Ŷ = 4
Error = 5 − 4 = +1
כאן השגיאה חיובית, משום שהרשת חזתה מספר נמוך מהתוצאה האמיתית.
נחשב את כל השגיאות:
| X | Y אמיתי | Ŷ חזוי | Error = Y − Ŷ |
|---|---|---|---|
| 0 | 1 | 1.5 | −0.5 |
| 1 | 3 | 2.5 | +0.5 |
| 2 | 5 | 4.0 | +1.0 |
| 3 | 7 | 6.5 | +0.5 |
| 4 | 9 | 8.5 | +0.5 |
4. מהי שגיאה בריבוע? Squared Error
לאחר שחישבנו את השגיאות, אנחנו מעלים כל שגיאה בריבוע.
מה המשמעות של העלאה בריבוע?
מכפילים את המספר בעצמו.
לדוגמה:
2² = 2 × 2 = 4
3² = 3 × 3 = 9
גם מספר שלילי אפשר להעלות בריבוע:
(−2)² = (−2) × (−2) = 4
מכפלה של שני מספרים שליליים היא מספר חיובי.
נחזור לדוגמה שלנו.
השגיאה הראשונה:
Error = −0.5
נעלה בריבוע:
Error² = (−0.5) × (−0.5) = 0.25
נחשב את השגיאות הריבועיות של כל הדוגמאות:
| X | Y אמיתי | Ŷ חזוי | Error = Y − Ŷ | Error² |
|---|---|---|---|---|
| 0 | 1 | 1.5 | −0.5 | 0.25 |
| 1 | 3 | 2.5 | +0.5 | 0.25 |
| 2 | 5 | 4.0 | +1.0 | 1.00 |
| 3 | 7 | 6.5 | +0.5 | 0.25 |
| 4 | 9 | 8.5 | +0.5 | 0.25 |
| סה"כ | 2.00 |
5. מדוע מעלים את השגיאה בריבוע?
יש שלוש סיבות חשובות.
סיבה ראשונה: למנוע ביטול בין שגיאות חיוביות ושליליות
נניח שהרשת טעתה פעמיים.
בטעות הראשונה:
Error = −2
בטעות השנייה:
Error = +2
אם נחבר את השגיאות:
−2 + 2 = 0
נקבל אפס, למרות שהרשת טעתה בשתי הדוגמאות!
אבל כאשר מעלים בריבוע:
(−2)² = 4
(+2)² = 4
כעת:
4 + 4 = 8
השגיאות כבר אינן מבטלות זו את זו.
סיבה שנייה: להעניש יותר על שגיאות גדולות
נבחן את הטבלה:
| גודל השגיאה | השגיאה בריבוע |
|---|---|
| 0 | 0 |
| 1 | 1 |
| 2 | 4 |
| 3 | 9 |
| 4 | 16 |
| 5 | 25 |
אפשר לראות שככל שהשגיאה גדלה, הריבוע שלה גדל במהירות רבה יותר.
לדוגמה:
שגיאה בגודל 2 נותנת ריבוע של 4.
שגיאה בגודל 4 נותנת ריבוע של 16.
כלומר, כאשר גודל השגיאה גדל פי שניים, השגיאה הריבועית גדלה פי ארבעה.
לכן MSE נותן משקל גדול יותר לטעויות גדולות.
סיבה שלישית: לאפשר למידה באמצעות נגזרות
אחת השיטות המרכזיות ללימוד רשתות נוירונים מבוססת על חישוב נגזרות.
נגזרת היא כלי מתמטי שעוזר לנו לדעת כיצד שינוי קטן במספר מסוים משפיע על התוצאה.
פונקציית השגיאה הריבועית נוחה לחישוב נגזרות.
בהמשך נראה כיצד הרשת משתמשת בנגזרות כדי לשפר את המשקלים שלה.
6. כיצד מחשבים MSE?
כעת יש לנו את כל המידע הדרוש.
תחילה חישבנו את השגיאות.
לאחר מכן העלינו כל שגיאה בריבוע.
עכשיו נחשב את הממוצע של כל השגיאות הריבועיות.
שלב ראשון: נחבר את כל השגיאות הריבועיות.
0.25 + 0.25 + 1.00 + 0.25 + 0.25 = 2.00
לתוצאה הזאת קוראים:
SSE – Sum of Squared Errors
כלומר, סכום השגיאות הריבועיות.
שלב שני: נספור כמה דוגמאות יש לנו.
יש לנו חמש דוגמאות.
N = 5
שלב שלישי: נחלק את סכום השגיאות הריבועיות במספר הדוגמאות.
MSE = SSE / N
נציב את הנתונים:
MSE = 2 / 5
MSE = 0.4
זוהי התוצאה הסופית.
כלומר, ממוצע השגיאות הריבועיות של חמש התחזיות הוא 0.4.
הנוסחה הכללית היא:
MSE = סכום כל הערכים של (Y − Ŷ)² / מספר הדוגמאות
חשוב לדעת: MSE אינו השגיאה הממוצעת הרגילה ביחידות של Y, אלא ממוצע השגיאות לאחר העלאתן בריבוע.
7. כיצד הרשת משתמשת ב־MSE כדי ללמוד?
כעת מגיע החלק החשוב ביותר.
אנחנו יודעים לחשב את ה־MSE, אבל כיצד רשת הנוירונים יודעת לשפר את התוצאות?
ברשת נוירונים קיימים מספרים שנקראים:
Weights – משקלים
Biases – הטיות
אלו מספרים שהרשת משנה במהלך האימון.
ניקח לדוגמה נוירון פשוט שמחשב:
Ŷ = W × X + b
כאשר:
- X הוא הקלט.
- W הוא המשקל.
- b הוא ה־Bias.
- Ŷ הוא הערך שהרשת חוזה.
לדוגמה, נניח שהקלט הוא:
X = 2
והתוצאה האמיתית היא:
Y = 5
בתחילת האימון המשקל וה־Bias הם:
W = 1
b = 0
התחזית תהיה:
Ŷ = 1 × 2 + 0
Ŷ = 2
אבל התוצאה האמיתית היא 5.
נחשב את השגיאה:
Error = 5 − 2 = 3
נעלה בריבוע:
Error² = 3 × 3 = 9
מכיוון שיש בדוגמה הזו נתון אחד בלבד:
MSE = 9
הרשת צריכה לשנות את W ואת b כדי להקטין את השגיאה.
8. כיצד הרשת יודעת אילו משקלים לשנות?
הרשת משתמשת בכלי מתמטי שנקרא:
Derivative – נגזרת
הנגזרת עוזרת להבין כיצד שינוי קטן במשקל או ב־Bias ישפיע על ה־MSE.
לדוגמה:
אם הגדלת המשקל מקטינה את השגיאה, כדאי להגדיל אותו בצעד מתאים.
אם הגדלת המשקל מגדילה את השגיאה, כדאי להקטין אותו בצעד מתאים.
כדי לחשב את כיוון השינוי משתמשים בשיטה הנקראת:
Gradient Descent – ירידת גרדיאנט
במילים פשוטות, הרשת מנסה להתקדם בכיוון שבו השגיאה קטנה.
ברשתות נוירונים הכוללות מספר שכבות, מחשבים את השפעת כל המשקלים וההטיות באמצעות שיטה שנקראת:
Backpropagation – הפצת השגיאה לאחור
חשוב להבין: הרשת אינה משנה את המשקלים באופן אקראי. היא מחשבת נגזרות המראות כיצד שינוי בכל פרמטר משפיע על השגיאה.
אלגוריתם האימון משתמש בנגזרות כדי לקבוע את העדכונים.
9. מה קורה בקוד TensorFlow שלנו?
בקוד Python הגדרנו:
|
1 2 3 4 |
model.compile( optimizer='adam', loss='mean_squared_error' ) |
שתי ההגדרות חשובות.
loss='mean_squared_error'
אנחנו אומרים ל־TensorFlow להשתמש ב־MSE כדי למדוד את שגיאת התחזיות.
optimizer='adam'
אנחנו אומרים ל־TensorFlow להשתמש באלגוריתם Adam כדי לעדכן את המשקלים וההטיות.
Adam משתמש בנגזרות ובמידע שנצבר מעדכונים קודמים כדי לקבוע כיצד לשנות את הפרמטרים.
בכל שלב אימון הרשת מבצעת את הפעולות הבאות:
- מקבלת נתוני X.
- מחשבת תחזיות Ŷ בעזרת המשקלים וההטיות הנוכחיים.
- משווה את התחזיות לתוצאות האמיתיות Y.
- מחשבת את ה־MSE.
- מחשבת נגזרות באמצעות Backpropagation.
- מעדכנת את המשקלים וההטיות באמצעות Adam.
- ממשיכה באימון כדי לנסות להקטין את השגיאה.
כל התהליך מתבצע באופן אוטומטי על ידי TensorFlow.
10. מה קורה ל־MSE במהלך האימון?
נניח שאנחנו מאמנים רשת במשך 250 Epochs.
Epoch הוא מעבר אחד על כל נתוני האימון.
לדוגמה, ייתכן שנקבל את התוצאות הבאות:
| Epoch | MSE |
|---|---|
| 1 | 12.50 |
| 20 | 8.20 |
| 50 | 4.10 |
| 100 | 1.50 |
| 150 | 0.50 |
| 200 | 0.15 |
| 250 | 0.03 |
אלו תוצאות להמחשה בלבד.
אפשר לראות שה־MSE הולך וקטן.
המשמעות היא שהרשת משפרת את ההתאמה שלה לנתוני האימון.
עם זאת, MSE לא חייב לרדת בכל Epoch, וגם MSE נמוך אינו מבטיח תחזיות טובות על נתונים חדשים.
כדי לבדוק זאת, נהוג להשתמש גם בנתוני Validation שלא משמשים לעדכון המשקלים.
11. סיכום – מה למדנו?
רשת נוירונים לומדת באמצעות שינוי משקלים והטיות.
היא אינה חייבת לדעת מראש את המשוואה המתמטית שיצרה את הנתונים.
היא מנסה ללמוד פונקציה שמקשרת בין הקלט X לתוצאה Y.
כדי לשפר את הלמידה אנחנו משתמשים ב־MSE.
MSE מודד את ממוצע השגיאות הריבועיות של תחזיות הרשת.
במהלך האימון:
- הרשת מחשבת תחזיות.
- מחשבת שגיאות.
- מחשבת MSE.
- משתמשת בנגזרות כדי לבדוק כיצד המשקלים משפיעים על השגיאה.
- מעדכנת משקלים והטיות באמצעות Optimizer.
- חוזרת על התהליך לאורך האימון.
המשפט החשוב ביותר בהרצאה:
רשת נוירונים לומדת באמצעות חישוב השגיאה בין התחזיות שלה לבין התוצאות האמיתיות, ושינוי המשקלים וההטיות כדי להקטין את השגיאה.
זהו אחד העקרונות המרכזיים שעליהם מבוססת למידת רשתות נוירונים מלאכותיות.
חלק ב : תרגול : הרצת תרגיל (עם קוד פשוט ) רשתות נוירונים פרדיקציה
קישור :
https://colab.research.google.com/drive/1aS5y_LKPePjloHi57PZforMGqOESZGgX?usp=sharing


4. ,תרגיל כיתה : בניית רשת נוירונים בעזרת בינה מלאכותית
4.1 בנה בעזרת בינה מלאכותית רשת נוירונים בקוד פייתון – בסביבת פיתוח קולאב אשר מקבל את הנתונים הבאים
4.2 טוענת קובץ אקסל EXCEL – ממחשב PC ל מחשב COLAB – polynomial_minus2_plus2_25_points
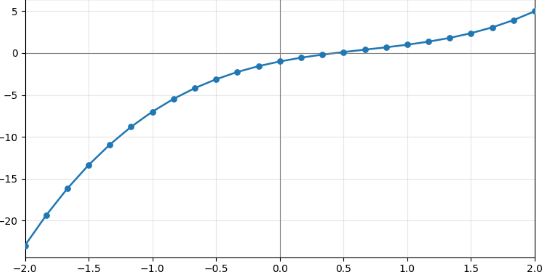
4.3 נבא את התוצאות : הבאות
של Y כאשר C
0
-1.3
2.2
-19
4.4 הצג את תוצאות הניבוי על גרף
נתונים ערכים לשאלה :
polynomial_minus2_plus2_25_points
About the Author