מבוא לבינה מלאכותית RB40-04 : רשתות נוירונים חלק 2
חלק א: בינה מלאכותית וחדש בשכונה
חלק ב : ניתוח קובץ אקסל
- נתח את קובץ האקסל exp1 יבא אותו ל chatGpt
1.1 בקשו גרף קורלציות מפת חום בין הטבלאות איפה ניראה שיש קורלציות Correlation Map Between Columns
- בקשו הבינה המלאכותית – לנתח את הנתונים
2.1 כמה קבוצות של רמה בחשבון יש ?
2.2 מה הפרמטרים שמשפעים על כל קבוצה – הנמוכה 0 , והקבוצה 3 הגבוהה ביותר
2.3 איזה עצה היית נותן שיש לאנשים הכנסה נמוכה ואין כסף למורים פרטים עבור שלהם שלהם יהיו טובים בחשבון ?
3.3 לפי הנתונים האלה האם לכל ילד שנולד יש הזדמנות טובה להיות טוב במתמטיקה ?
חלק ג : יצירת וידאו A.I
יצירת וידאו – מטקסט : שיווק מוצר עם בינה מלאכותית
צירת וידאו : מתמונה וטקסט – שיווק מוצר עם בינה מלאכותית
חלק ד : ניתוח קבצי PDF שוק הנלדן בישראל
תרגיל כיתה 1 : ניתוח והשוואה נתוני נלדן 2025 2024 2021 PDF
בעזרת בינה מלאכותית
הורד את קבצי הנלד"ן PDF
2001-nadlan
2024-nadlan
- טען את קובץ הנתונים הבא של שנת 2001 בלבד
- באיזה תחום הוא עוסק ?
- בנה תקציר- קצר מאוד של הקובץ מבוסס על מספרים ועובדות ובנה טבלת השוואה מקוצרת
- טען את הקבצים לשנת 2021 ו 2024 2025
- בנה טבלת סיכום נתונים לכל שנה בניפרד
- בקש לצרף גרף טבלת השוואה ומגמה של קבצי ה PDF שיכללו את השנים הרלוונטיות בטבלה ובגרפים
- במה שונה כל שונה בטובה ולרעה
- בנה דוח מסקנות
הרצu את הרגיל ב LLM נוסף
- נתח בנוסף גם בעזרת Gemini או GROK או claode.ai
חלק ה: לימוד פייתון עבור בינה מלאכותית
ANN -Scaling
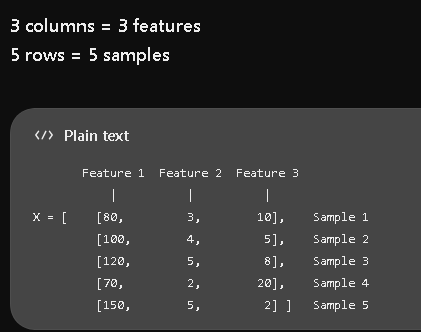
ב-ANN משתמשים ב-Scaling כדי לשפר את מהירות ויציבות הלמידה.
כאשר ערכי הקלט גדולים מאוד, הם עלולים לגרום לנגזרות (Gradients) גדולות, ובעקבות זאת לשינויים קיצוניים במשקלים (Weights). כך הרשת עלולה לדלג מעל נקודת המינימום של השגיאה ולא להתכנס.
Scaling מעביר את הנתונים לטווח מספרי מבוקר, למשל 0 עד 1, וכך עשוי לאזן את הנגזרות ולאפשר ל-Gradient Descent להתכנס מהר יותר ובצורה יציבה יותר.
המטרה: למידה מהירה, יציבה ויעילה יותר, עם פחות תנודות בשגיאה.
קישור להרצה
|
1 2 3 4 5 6 |
import numpy as np # 1. Create 150 random integers in a 2D array X = np.random.randint(-2004, 1035, size=(15, 10)) print(X) print("Original shape:", X.shape) |
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 |
[[ 967 -1779 -201 408 116 -1023 -613 -137 -1356 123] [ -393 634 -604 -472 323 -1483 -572 -1931 -173 -1098] [ -736 -859 -600 -1475 416 -609 -460 939 687 -707] [ -166 -1956 -201 -609 -1619 -1982 -127 -414 -466 -1480] [-1183 -1193 189 756 -1048 -1473 921 -1806 -777 438] [ 676 -734 438 310 -859 913 -1502 -1105 -795 -223] [-1522 337 88 -712 -876 863 -1479 695 494 280] [ -242 -1382 -1173 203 -1211 553 -914 1008 242 -516] [ 433 630 -1691 -287 -1447 -1258 1026 -373 838 -1384] [ -471 -1781 38 962 928 590 -1700 -1532 -244 796] [-1399 717 -37 403 -661 -1263 -269 1021 -482 768] [ 429 -1886 -1917 -93 974 -535 -164 -1185 -259 -720] [-1006 -870 -294 -1035 337 -1266 361 -402 -1368 508] [ 975 458 -1730 -27 592 379 563 -104 -437 -334] [ -804 -1025 328 776 724 498 299 -1043 110 812]] Original shape: (15, 10) |
|
1 2 3 4 5 6 7 8 9 10 |
# 2. Reshape 2D to 1D X = X.reshape(-1) print("1D shape:", X.shape) print("\n1D array:") print(X[0:10]) print("\nThe first 5") print(X[:5]) # from the start to cell number 5 print("\nThe last 5") print(X[-5:]) # from the last 5 cell to the end |
output
|
1 2 3 4 5 6 7 8 9 10 |
1D shape: (150,) 1D array: [ 967 -1779 -201 408 116 -1023 -613 -137 -1356 123] The first 5 [ 967 -1779 -201 408 116] The last 5 [ 498 299 -1043 110 812] |
|
1 2 3 4 5 6 7 8 9 10 11 |
# 3. Scaling [-2004, 1034] to [-1, 1] min_val = -2004 max_val = 1034 X_scaled = 2 * (X - min_val) / (max_val - min_val) - 1 # 4. Print first 10 scaled values print("\nFirst 10 scaled values:") print(X_scaled[:10]) print(X[:10]) |
output
|
1 2 3 4 |
First 10 scaled values: [ 0.95589203 -0.85187623 0.18696511 0.58788677 0.39565504 -0.35418038 -0.08426596 0.22909809 -0.57340355 0.40026333] [ 967 -1779 -201 408 116 -1023 -613 -137 -1356 123] |
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
# 5. Select 5 random positions indices = np.random.choice(150, 5, replace=False) print(indices) # 6. Inverse Scaling print("\nOriginal | Scaled | Restored") for i in indices: original = X[i] scaled = X_scaled[i] restored = (scaled + 1) / 2 * (max_val - min_val) + min_val print(original, "|", round(scaled, 4), "|", round(restored)) |
output
|
1 2 3 4 5 6 7 8 |
[ 57 61 14 149 47] Original | Scaled | Restored -1105 | -0.4082 | -1105 337 | 0.5411 | 337 323 | 0.5319 | 323 812 | 0.8539 | 812 -1806 | -0.8697 | -1806 |
חלוקה 70 אחוז , 15 אחוז , 15 אחוז של נתונים
-
np.random.randint()– יצירת מספרים אקראיים. -
reshape(-1, 1)– הפיכת הנתונים למערך דו־ממדי עם Feature אחד. -
train_test_split()– חלוקת X ו-Y יחד תוך שמירת הקשר ביניהם. -
np.linspace()– יצירת ערכי X מסודרים לציור גרף חלק. -
plt.plot()– ציור הפונקציה המתמטית. -
plt.scatter()– הצגת דוגמאות האימון, האימות והבדיקה.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 |
# ============================================================ # ANN EXERCISE - POLYNOMIAL DATASET # Generate 300 random samples # Split data into Training (70%), Validation (15%), Test (15%) # Display the polynomial function and datasets # ============================================================ import numpy as np import matplotlib.pyplot as plt from sklearn.model_selection import train_test_split # ------------------------------------------------------------ # STEP 1 - Generate 300 random X values # ------------------------------------------------------------ np.random.seed(42) # Same random numbers every execution X = np.random.randint(-1000, 1001, size=300) # ------------------------------------------------------------ # STEP 2 - Calculate Y using a polynomial equation # Y = 0.001*X^3 - 0.5*X^2 + 100*X + 5000 # ------------------------------------------------------------ Y = 0.001 * X**3 - 0.5 * X**2 + 100 * X + 5000 # ------------------------------------------------------------ # STEP 3 - Reshape X and Y into 2D arrays # Each row represents one sample # ------------------------------------------------------------ X = X.reshape(-1, 1) # Shape: (300, 1) Y = Y.reshape(-1, 1) # Shape: (300, 1) # ------------------------------------------------------------ # STEP 4 - Split 70% Training and 30% remaining # X and Y are split together to preserve their relationship # ------------------------------------------------------------ X_train, X_temp, Y_train, Y_temp = train_test_split( X, Y, test_size=0.30, random_state=42 ) # ------------------------------------------------------------ # STEP 5 - Split remaining 30% into two equal groups # Validation = 15% of total # Testing = 15% of total # ------------------------------------------------------------ X_val, X_test, Y_val, Y_test = train_test_split( X_temp, Y_temp, test_size=0.50, random_state=42 ) # ------------------------------------------------------------ # STEP 6 - Display array dimensions # ------------------------------------------------------------ print("Original X:", X.shape) print("Original Y:", Y.shape) print("Training:", X_train.shape, Y_train.shape) print("Validation:", X_val.shape, Y_val.shape) print("Testing:", X_test.shape, Y_test.shape) # ------------------------------------------------------------ # STEP 7 - Display the first 5 Training samples # ------------------------------------------------------------ print("\nFirst 5 Training Samples:") for i in range(5): print("X =", X_train[i, 0], "Y =", Y_train[i, 0]) # ------------------------------------------------------------ # STEP 8 - Generate a smooth polynomial curve for plotting # ------------------------------------------------------------ X_graph = np.linspace(-1000, 1000, 1000) Y_graph = ( 0.001 * X_graph**3 - 0.5 * X_graph**2 + 100 * X_graph + 5000 ) # ------------------------------------------------------------ # STEP 9 - Plot the polynomial and all three datasets # ------------------------------------------------------------ plt.figure(figsize=(10, 6)) # Original polynomial function plt.plot( X_graph, Y_graph, color="black", linewidth=2, label="Original Polynomial" ) # Training samples plt.scatter( X_train, Y_train, color="blue", s=12, label="Training 70%" ) # Validation samples plt.scatter( X_val, Y_val, color="green", s=25, label="Validation 15%" ) # Testing samples plt.scatter( X_test, Y_test, color="red", s=25, label="Testing 15%" ) # Graph settings plt.xlabel("X Values") plt.ylabel("Y Values") plt.title("ANN Polynomial Dataset - Training / Validation / Testing") plt.grid(True) plt.legend() plt.show() |
חלק ו: תרגיל כיתה בינה מלאכותית – בינה מלאכותית
תרגיל 1 – בניית מודל של פולינום – תרגיל חזרה
נתונה הפונקציה הפולינומית
Y = 0.001 * X**3 – 0.5 * X**2 + 100 * X + 5000
-
צירת 300 מספרים אקראיים בטווח -1000 עד 1000 וחישוב Y.
-
חלוקת הנתונים ל-70% Training, 15% Validation ו-15% Testing.
-
ביצוע Scaling ל-X ול-Y בטווח -1 עד 1.
-
בניית ANN עם שתי שכבות נסתרות ופונקציית ReLU.
-
אימון במשך 50 Epochs, שמירת התחזיות, והמשך האימון עד 250 Epochs.
-
הצגת גרפים של
Loss, Validation Lossוהשוואת תחזיות ANN לפונקציה המקורית -
תרגיל 2 – בניית מודל ברשת ANN עבוד גז אידאלי
בנה מודל עבור משוואת הגז האידאלי
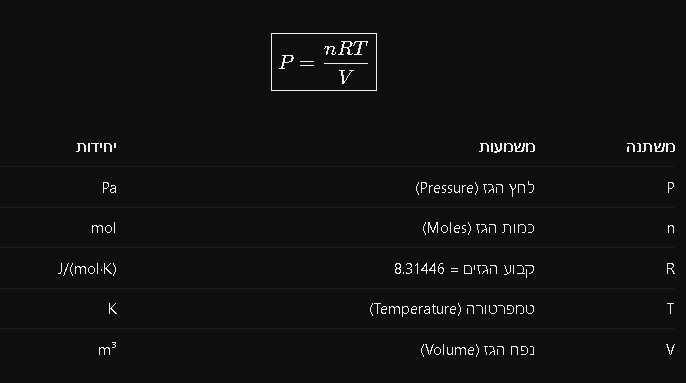
דרישות התרגיל
-
יצירת 300 דוגמאות אקראיות של
n, T, V. -
חישוב הלחץ האמיתי
Pלפי המשוואה. -
חלוקת הנתונים: 70% Training, 15% Validation, 15% Testing.
-
ביצוע Min-Max Scaling לטווח -1 עד 1.
-
בניית ANN עם שלוש כניסות, שתי שכבות נסתרות ויציאה אחת.
-
אימון 50 Epochs ולאחר מכן המשך ל-250 Epochs.
-
הצגת
Training Loss, Validation Loss, MAE, RMSE. -
השוואת התחזיות למשוואה הפיזיקלית וציור גרפים
About the Author